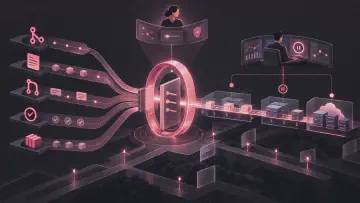
圖片來源:由 OpenAI Image Generation 生成。

[AI 軟體工程] 授權邊界不會消失,只會上移:從 Human-in-the-loop 到 Human-on-the-loop

前三篇依序談 Contract(合約)、Evidence(證據)與 Attestation(獨立確認);本文聚焦信任鏈的最後一環:Authority(授權),以及如何依風險在 Human-in-the-loop 與 Human-on-the-loop 之間配置人的決策位置。本文可以獨立閱讀。 前言 先從一個常被混淆的問題開始:所有必要檢查都通過、審查也完成了,是不是就等於可以合併、發布或上線? 前一篇已經把驗收和獨立確認分開。Evidence 回答「在已定義的檢查條件下,結果是否符合預期」;Attestation 則由與產出角色分離的審查者或審查機制,判斷這些證據是否足以支撐受治理需求。Authority 要回答的是另一個問題:誰有權依照什麼規則,做出合併、發布、部署或正式放行的決定? 因此,檢查通過與審查完成,不會自動產生放行權限。若把「驗收結果」直接當成「授權結果」,責任邊界就會被綁在檢查的完備性上;而任何檢查都不可能覆蓋所有情境。 commit、push 與放行是不同的授權動作 授權分離的重點是: commit、push、merge、publish 與 deploy 是不同動作;完成前一個動作,不會自動取得下一個動作的 Authority。 在許多流程裡,這些動作可能被串成一條自動化路徑:push 之後執行 CI,CI 通過後自動 merge,再由部署流程發布。自動化本身不是問題,問題在於每一個放行動作是否都有明確的治理規則、適用範圍與授權來源。 放到 agent 的工作流程裡,可以先分清楚幾件事: agent 可以在授權範圍內建立 commit 或 push 變更,但這只代表版本被提出或送進流程,不代表需求已經被核准。 Evidence 與 Attestation 都完整,也不代表自動取得 merge、publish 或 deploy 的權限。 merge、publish 與 deploy 可以由人類明確決定,也可以由事先核准的政策自動串接;前提是每一步的放行條件與授權來源,都已經由治理規則明確定義。 每一個放行結果都應該能回到一條清楚的授權規則,而不是前一步流程的無條件延伸。 薄介面:入口不能偷偷升級授權 現代的 agent 工具通常會用不同入口操作同一套流程:命令列(CLI)、給 agent 使用的 MCP、CI 的 adapter,或其他內部服務。如果每個介面各自實作一套授權規則,規則就可能逐漸漂移:某個入口多開了一個操作,另一個入口的把關又比其他地方寬鬆。 比較實務的做法,是把這些介面維持成薄介面:負責解析輸入、基本格式驗證、authentication / scope 檢查、呼叫共用的治理邏輯,再把結果格式化輸出。真正涉及敏感操作的 authorization,仍應在共用的受治理路徑中重新確認。 多加一個介面,可以多一個入口,但不應因此多出一份 Authority。 CLI、MCP 或 CI adapter 都可以有自己的 authentication、authorization 或 scope 檢查,但不能自行擴大底層已授予的權限。能呼叫某個 tool,不等於有權執行底層的敏感動作。...
September 10, 2026 · 1 min · yishiashia
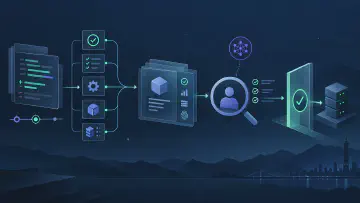
圖片來源:由 OpenAI Image Generation 生成。

[AI 軟體工程] 驗收即證據:LLM 審查不能單獨放行,審查通過也不等於可以合併

本文聚焦 harness engineering 信任鏈的核心:Evidence(證據) 與 Attestation(獨立確認)。兩者分別回答「在已定義的檢查條件下,結果是否符合預期」與「這些證據是否足以支持產出符合需求意圖」。 前言 有了綁定好的合約之後,下一個問題是:agent 交出東西之後,如何證明它真的符合合約? 這時很容易想到:既然 LLM 可以產出程式碼,那就再請另一個 LLM 進行 review,協助找問題、補充測試方向,或提供審查意見。這種做法有價值,但不能單獨成為最終放行依據。 換另一個 LLM,不會自動把帶有機率性的判斷(probabilistic judgment)變成可重現的 Evidence。不同模型、prompt 與工具仍然可能提供有價值的 review,但判斷也可能受到模型版本、context、推論結果與提示方式影響。 LLM 的審查是判斷,不是證明。它可以參與 Attestation,但不能只因為它說 OK,就把這句話直接當成 Evidence。 所以驗收這件事,可以拆成兩個角色不同的半場:可重現的檢查負責產出 Evidence,與產出角色分離的審查者或審查機制負責 Attestation。兩者都不能被繞過,也不能互相取代。 上半場:驗收即證據(Evidence) 先講機器這半場。這裡的重點是可重現性。 為什麼要可重現 證據的價值,來自它能在固定版本、執行環境與參數下重跑,得到可以比較的結果。驗收檢查需要把這些條件固定下來: Evidence 要綁定實際被驗收的 source revision,例如對應的 commit / tree 與必要的 diff,不只是假設某個 branch HEAD。 固定工具與 runtime 版本、依賴版本、執行參數、設定、輸入與必要的環境條件,並把這些資訊記錄進 Evidence。 必要 gate 的通過與否,不由單一 LLM 判斷決定;LLM review 可以作為審查輸入或輔助。 Evidence 可以證明產出在已定義的檢查條件與範圍內符合預期;這個結論只涵蓋被指定的版本、環境、輸入與驗收條件,不能證明所有未被覆蓋的情境都正確,也不能延伸成整個系統完全正確。 證據要綁定確切版本 每份 Evidence 都應該綁定實際被驗收的 source revision,例如對應的 commit / tree、必要的 diff,以及工具與 runtime 版本、執行參數和相關的環境條件。若工作目錄仍有未納入版本控制的變更,這些狀態也必須被拒絕或明確記錄。...

September 10, 2026 · 1 min · yishiashia
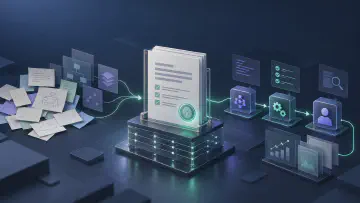
圖片來源:由 OpenAI Image Generation 生成。

[AI 軟體工程] 規格即合約:把「要做什麼」固定成可驗證的版本基準

上一篇將 harness engineering 的信任鏈拆成四個環節:Contract(合約)、Evidence(證據)、Attestation(獨立確認)、Authority(授權)。本文接著談第一環:如何把「要做什麼」說清楚、固定下來,讓後面的驗收真的有東西可以對照。 前言 使用 coding agent 時,最容易被低估的問題,往往是它會不會在過程中重新解讀需求,而不只是它會不會寫 code。 需求已經約定好,範圍也說得清清楚楚。agent 開始動工,過程中一路調整、一路「幫忙想得更周到」。等到交出成果,diff 裡的每一段單獨看都很合理 —— 但整體加起來,卻不太是原本要的東西。 範圍悄悄長大了一點、某個原本說好「不做」的地方被順手做了,甚至有些約定在過程中被重新解讀。最後很難指出到底是哪一個時間點出了問題,只知道成果和一開始談的內容已經有一段距離。 這類問題很容易被歸咎於「模型不聽話」。但回頭看流程,問題往往更基本:當初講好的內容,從頭到尾就沒有被固定下來。 需求散落在 issue、聊天記錄、口頭討論裡,而這些內容都可以被重新詮釋。既然「完成的定義」可以事後被改寫,後面的驗收就很難有明確依據 —— 最後甚至可能在不知不覺中接受「這樣好像也算做完了」的結果。 所以信任鏈的第一環,不是驗收,而是合約。 本文不從某個 CLI 指令開始,而是從一套可以放進不同工具與流程的軟體工程方法談起:先宣告邊界,再建立後續可以對照的版本基準。 整篇文章想回答一個問題:如果規格今天被修改,是否能清楚指出哪一個版本曾經被同意、內容是否被動過,以及這次修改是否需要重新驗收? 為什麼自然語言的規格還不夠? 自然語言仍然是規格的重要載體。問題在於,不能單獨依靠一份可以自由修改、缺乏版本與識別碼的 prose 作為治理基準。 同一句話,不同人讀、不同時間讀,甚至同一個 agent 在不同 context 下讀,都可能得到不一樣的理解。當執行者可以高速產出,原本看似不大的模糊,就可能被放大成真正的範圍偏移。 治理需要做的,是在自然語言之外補上明確的需求 ID、non-goals、acceptance criteria、版本化快照與合約指紋,讓後續可以比對、重算,也看得出版本是否被改過。 為了方便後續討論,本文把這兩個方法論動作稱為 DECLARE(宣告) 與 BIND(綁定)。它們並非 Harness Engineering、SDD 或業界既有標準中的固定指令;本文用這兩個名稱分開描述「討論需求」和「建立版本基準」。 動作一:DECLARE —— 先把邊界說清楚 DECLARE 可以理解成把「要做什麼、不做什麼」整理清楚的階段。這裡通常會留下幾類內容: Spec(規格文件):描述這個功能要達成什麼、怎麼驗收,以及什麼情況才算完成。 ADR(Architecture Decision Record,架構決策紀錄):採用這個方案的理由、放棄了哪些選項,以及這個決定帶來哪些約束。 non-goals(非目標):這次明確不處理的事情,例如不改既有 API、不處理權限、不做效能最佳化。 「不做什麼」,跟「做什麼」一樣重要。 大多數規格只寫要完成的事情,結果 agent(跟人一樣)會在灰色地帶自由發揮。把 non-goals 和 acceptance criteria 一起寫清楚,才能同時畫出「不做什麼」的邊界,以及可以逐條確認的完成條件。 Agent 可以協助整理規格、找出矛盾或提出修改方案,但不應在未經授權的情況下自行擴大工作範圍,也不能自行把修改後的規格視為新的治理基準。DECLARE 的終點,是由有權限的人確認這份內容可以拿來當作這次工作的合約。 從散文規格到可追蹤需求 在採用 SDD(Spec-Driven Development,規格驅動開發)的工作流裡,規格、計畫與任務文件是主要的產物。已確認的需求可以使用固定識別碼標示,例如:...

September 10, 2026 · 2 min · yishiashia
圖片來源: 由 [Google Gemini](https://gemini.google.com/app?hl=zh-TW) AI 生成。

[AI 軟體工程] Harness Engineering 介紹:用驗證與治理讓 AI Agent 的產出更可靠

這篇文章是《Harness Engineering:讓自主 AI 軟體工程可被信任的治理方法論》系列的總覽,也可以獨立閱讀。本篇先從問題與整體框架出發,整理出「合約、證據、獨立確認、授權」四個治理支柱。 前言 用過 Claude Code、Codex 或 GitHub Copilot 這類 coding agent 的人,大概都有過一種矛盾的感受:它產出程式碼的速度快得驚人,快到你根本來不及一行一行看完。 一開始會覺得:這太讚了吧,工作速度與效率都明顯提高了。 但問題是,AI 產 code 的速度實在太快了,人類 review 的速度根本跟不上。為了維持產出的速度,最後常常乾脆選擇相信 AI,直接 approve 或 merge,但內心總是忍不住懷疑:這樣真的對嗎? 這段程式碼真的是照當初講好的需求做的嗎? 出事的時候,責任算誰的? 它有沒有悄悄違反我們的架構決策? 到底什麼時候才能安全地把它合併、上線? 先前介紹 WebMCP 時有提到:涉及交易或破壞性的重要操作,一定要設計「Human-in-the-loop」的最後確認機制。那句話其實只是冰山一角。當 AI 從「幫你查資料的聊天機器人」變成「幫你動手改 code 的 agent」,我們需要的就不再只是「一個確認按鈕」,而是一整套讓機器產出可被信任的工程方法。 這套「讓機器產出可被信任」的工程方法,近來開始出現在更多軟體工程討論裡,通常稱作 harness engineering。OpenAI 在一篇文章 《Harness engineering: leveraging Codex in an agent-first world》 中,分享了一種「工程師幾乎不親手寫 code,而是去打造讓 agent 不出錯的結構、文件與自動檢查」的 agent-first 開發實踐。而這個系列想談的,不是怎麼操作某個工具,而是它背後的治理方法論。 什麼是 harness engineering? 先講「harness」這個字。它原本是「馬具、輓具」的意思 —— 套在馬身上、讓馬的力氣能被駕馭、用在對的方向上的那組裝備。 放到 AI 的世界,harness 指的是「讓一個語言模型變成可靠 agent 的那層骨架」:工具(tools)、流程(workflow)、驗收(verification)、授權(authorization)。模型負責「產出」,harness 則決定「這份能力怎麼被安全地使用」。...

September 7, 2026 · 2 min · yishiashia
圖片來源: 由 [Google Gemini](https://gemini.google.com/app?hl=zh-TW) AI 生成。

[前端開發] WebMCP 介紹與實作:讓 AI Agent 無縫操作你的網頁

前言 隨著 AI 技術的快速發展,AI Agent(智慧代理)已經不再只是聊天機器人,它們開始具備幫我們「執行網頁任務」的能力,例如:幫忙訂機票、比價、甚至是填寫複雜的報帳系統。 不過在過去,AI Agent 若要操作網頁,通常得依靠截圖分析 (Computer Vision) 或是解析原始 DOM 結構 (Screen Scraping) 來找到頁面上的元素。這些方法不但效率低落、耗費大量計算資源,而且非常脆弱:只要網頁的 UI 稍微改版(改個 class name 或換個按鈕顏色),Agent 就可能找不到目標元素而操作失敗。 為了從根本上解決這個問題,一項全新的網頁標準 —— WebMCP (Web Model Context Protocol) 誕生了。它由 W3C Web Machine Learning Community Group 孵化,並獲得 Google 與 Microsoft 的大力推動。本篇文章將帶大家認識 WebMCP 的核心概念與運作原理,並透過兩個實際的 Demo 來體驗如何讓現有的網頁變得 Agent-ready。 💡 小提醒:WebMCP 目前(2026 年初)仍處於早期預覽階段,需要在 Chrome 146 Canary 開啟特定 Flag 才能使用原生支援,但我們可以使用 @mcp-b/global polyfill 在開發階段進行測試。 什麼是 WebMCP? WebMCP (Web Model Context Protocol) 是一個瀏覽器原生 (Native Browser API) 的標準協議,主要是讓前端開發者可以用結構化、標準化的方式,將網頁的功能(Tools)「自我宣告」並暴露給 AI Agent。...

February 25, 2026 · 4 min · yishiashia